非明示添字配列と do over LOOPの利用

ARRAYステートメントを初めて覚える時、
 
array 配列名 {配列要素数} 以下、$や長さや配列要素内容や初期値といった感じで、

とりあえず array 配列名 {配列要素数} までは鉄板と覚えてしまいがちですが
それは正確には明示添字配列の定義法であり、
実は{配列要素数}を省略して定義することができます。

例えば、以下のようなデータセットがあっととします

data Q1;
X=1;Y=2;Z=3;output;
run;


XからZまでを配列として、配列要素全てに+1をする場合、
書き方はいくらでもありますが、例えば

data A0;
 set Q1;
 array AR{*} X--Z;
 do i=1 to dim(AR);
  AR{i}=AR{i}+1;
 end;
 drop i;
run;


と書いたとします。
ここでは{*}と要素数を定数にしていませんが、do to loopの終端条件で
dim関数でARの要素数を取得しているので問題ありません。

ただ、よくよく考えると、配列を定義して、その配列全部におんなじ処理を一括で
かける今回のような場合、要素番号ってあんまり役にたってません。

そこで実は以下のようなコードが成立します。

data A1;
 set Q1;
 array AR X--Z;
 do over AR;
  AR=AR+1;output;
 end;
run;

結果は同じです。
 array AR X--Z;と要素番号定義をすっとばしています。
 do i=1 to dim(AR);が do over AR;となっています。do overは全要素に対して順にループするという
 do i=1 to dim(AR);と同義になります。

ちなみに明示添字配列で定義した配列にdo overを使用すると以下のエラーメッセージです。


「ERROR: 明示添字配列に DO OVER ステートメントは使用できません。」

ただし、たとえば以下のコードのように非明示添字配列で定義しても
要素番号処理は裏でちゃんと勝手に行われているので

data A2;
 set Q1;
 array AR X--Z;
  A=AR{1};
  B=dim(AR);
run;


エラーになったりはしません。


FREQのtablesステートメントは複数指定できるという話

人が書いたコードを点検していた際の話ですが

data Q1;
X='い';Y=1;Z='A';output;
X='い';Y=2;Z='B';output;
X='ろ';Y=1;Z='A';output;
X='い';Y=1;Z='B';output;
X='は';Y=3;Z='A';output;
X='は';Y=3;Z='C';output;
run;

みたいに適当なデータセットがあり、それに対して

proc freq data=Q1 noprint;
 tables X/out=A1;
run;
proc freq data=Q1 noprint;
 tables X*Y/out=A2;
run;
proc freq data=Q1 noprint;
 tables Z/out=A3;
run;

とfreqを3連撃していたので、それって

proc freq data=Q1 noprint;
 tables X/out=A1;
 tables X*Y/out=A2;
 tables Z/out=A3;
run;

で1手で済んで、多分、実行速度的にもこっちの方が早いんじゃないかと言ったところ
「こんな書き方ができるとは!」って感じで、とても驚かれました。

そういうことってありますよね。僕も日々、そんなことできたんだって感動ばかりです


xステートメント(xコマンド)でファイルのコピー

外部ファイルをコピーするxコマンドについてよく忘れるので自分のためにメモです。
xコマンドはSASからOSにお願いをして、指定の命令を実行してもらうような機能です。
options noxwait;をつけないとコマンドプロンプトの黒画面が残ります。


options noxwait; 

x 'copy "D:\sample\AA.xlsx" "D:\sample\BB.xlsx"';

AAというエクセルファイルをコピーしてBBというエクセルファイルを作成します。

例えばアンケート調査をする時なんかに
まず、コピー元になるひな型アンケートフォームをエクセルで作って、
必要なexcel関数式や入力規則、名前の定義を指定しておきます。

そしてそれをlibnameで読み込むプログラムを書きます。

xコマンドをうまくマクロループで利用して、調査ID分、ひな型ファイルをコピーしまくる。

アンケートをばらまく→エクセルに記入してもらってそのファイルを回収
→読み込むプログラムをマクロループで繰り返して全部いっぺんにデータセット化みたいな風にすると、入力業務が省け、読み込みエラーも少なく、楽だと思います。
エクセルファイルをアクティブにせずにアクセスできるので、実行速度的にDDEより早いはずです。

ファイルの場所や名前にマクロ変数を入れる場合、クォート周りに要注意。

x "%str(copy %"&PATH.\BASE.xlsx%" %"&PATH.\COPYOUT.xlsx%" )";


tagsets excelxpでODS出力をエクセルファイルにする時に、セルの表示形式を設定する方法

例えば、以下のようなデータセットがあったとします。

data Q1;
IDNO='001';X='い';Y=1;output;
IDNO='002';X='ろ';Y=2.2;output;
run;


これに対して

ods tagsets.excelxp file='D:\A.xls';
proc print data=Q1 noobs;
 var IDNO X Y;
run;
ods tagsets.excelxp close;

とすれば、純粋なエクセルではないのでファイルが開く際に
確認のメッセージが入りますがOKすれば


こんな感じのエクセルファイルができると思います。

便利なのでちょっとした出力の際によく使うのですが、
これだとセルの表示形式が「標準」になってしまうため、「001」といったテキストが
1になってしまいます。

そういった場合に次のように書くことで回避できます。

ods tagsets.excelxp file='D:\B.xls';
proc print data=Q1 noobs;
 var IDNO/style={tagattr='format:text'};
 var X;
 var Y/style={tagattr='format:0.0'};
run;
ods tagsets.excelxp close;


/style={tagattr='format:text'}と打つことで「文字列」とすることができ、

また/style={tagattr='format:0.0'};で有効表示桁数を設定できます。


SASインタリーブ(interleave)の紹介と再帰的インタリーブで、SQL再マージ処理をデータステップで疑似的に表現する

インタリーブと聞くと、なんだっけそれ?となってしまいますが、たいしたことではなく
例えば

data Q1;
 do X=1,3,5;
  output;
 end;
run;
proc sort data=Q1;
 by X;
run;


data Q2;
 do X=2,4,6;
  output;
 end;
run;
proc sort data=Q2;
 by X;
run;


のようにソート変数の一致したデータセットが複数存在する場合

data A1;
 set Q1
     Q2;
  by X;
run;

とすると、以下のように


全てのデータセットを縦結合してからソートしなおす必要なく、ソートされた縦結合データセットが
得られるという技術のことです。

特に巨大なデータセットの場合、巨大なやつをつくってからproc sortするよりも、
小さい部品となるデータセットごとにソートしておいてインタリーブした方が、処理効率が
よいらしいです。


で今回のメインは処理効率の話ではなく
インタリーブをつかってSQL再マージと同様の自己参照処理をやってみようという話です。

SQL再マージ?という方はSAS忘備録の「SQL「再マージ」入門」を先に読んでください
http://sas-boubi.blogspot.jp/2013/12/sql_26.html


今、以下のデータセットがあったとします。

data Q3;
X='い';Y=1;output;
X='い';Y=5;output;
X='い';Y=9;output;
X='ろ';Y=2;output;
X='ろ';Y=3;output;
X='は';Y=2;output;
X='は';Y=4;output;
X='は';Y=6;output;
run;

proc sort data=Q3;
 by X;
run;


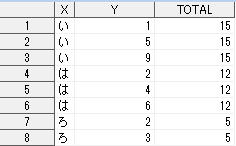
このデータセットに対して、もとのX,Yはそのままに、Xの値ごとのYの合計を一体化させたデータセットを作成したいとします。
つまり


上記の感じです。


SQL再マージで書くなら

proc sql noprint;
  create table  A0 as
  select  X,Y,sum(Y) as TOTAL
  from   Q3
  group by  X;
quit;

で詰みですね。

あるいはdo untilによる複数データステップの併合を利用して

data A00;

do until(last.X);
set Q3;
 by X;
 retain TOTAL;
 if first.X then TOTAL=.;
 TOTAL+Y;
end;

do until(last.X);
 set Q3;
 by X;
 output;
end;

run;

でも同じ結果になります。

【参考】do until(end変数)set end=を利用して、複数のデータステップを1つにまとめて共存させる方法
http://sas-tumesas.blogspot.jp/2013/12/do-untilendset-end1.html

ぱっと思いつきませんでしたが、call executeでもかけそうです。


脱線しました、他の方法を考えていると、きりがないです。
インタリーブで書くと、以下のようになります。

data A2;
 set Q3(in=in1)
     Q3;
  by X;
  retain TOTAL;
   if in1 then do; 
     if first.X then TOTAL = .; 
      TOTAL = sum(TOTAL,Y, 0); 
     end;
    else do;
      output; 
    end; 
run;

で詰みです。
ポイントは、setで敢えて元データを倍加重複させておいた上でインタリーブしてるところですね。
で、そのままだといけないので、in=で要約統計を出す部分と、実出力部分を分けているのですね。
タネさえ解れば、どうってことない処理ですね


SASにおけるPerl正規表現の存在を紹介するだけ

さんざん、マニアックなところを紹介しているのに、PRX系関数に一切触れないのはどうしてですか?というご質問をいただきました。

正直、痛いところを突かれたと思いました。
軽んじているわけではなく、まだ練習中で、あまり詳しくないからです。

ただ、PRX?という方もいらっしゃると思うので簡単な例だけ紹介します。

詳しくは「SAS Perl Regular Expressions」や「SAS 正規表現」で検索していただければ
よっぽど丁寧で詳細な資料がたくさん見つかるので、そちらで勉強してください。

正規表現は、乱暴にざっくりいうと文字のパターンマッチングのことです。
特にPerlというプログラミング言語に実装されている正規表現の書き方が、イケてる?ので
それに準じた機能をSASの関数にしましたよというのが、PRX関数です。


以前「whereステートメントでのみ使用できる演算子_contains,between,like」
http://sas-tumesas.blogspot.jp/search/label/like

でlike演算子を紹介しました。「 where X like '_B_D%' ;」のようにアンダースコアや%を使って、
文字のパターンを表現して、それにマッチしたものを抽出するといった機能でした。
感じとしては、これのゴージャス版です。

data Q1;
length X $20.;
X='123-xx';output;
X='12-xx';output;
X='423-XZ';output;
X='423_XZ';output;
X='000000 123-yy';output;
X='123-xy 123-xy 123-xy';output;
run;


ここでXの値に 数字3個の次にハイフンがきてその後 x か z か yの文字が2個続く
という特定のパターンが出現するかどうかを調べなければならないとします。

以下のコードと実行結果を見てください

data A1;
 set Q1;
  Y=PRXMATCH('/¥d{3}-[x-z]{2}/',X);
run;

まずPRXMATCH関数は、正規表現で指定したパターンが、対象変数のどの位置で
最初に出現するかを数字で返す関数です。0であれば、対象変数に指定したパターンは出現していないということです。

/¥d{3}-[x-z]{2}/ が正規表現の部分です。なんとなくわかるかもしれませんが¥d{3}が数字3個
-はそのままハイフン、[x-z]{2}がxかyかzが2個という部分に対応しています。

今は結果はYという変数に割り当てましたが、要はこれをIFステートメントに指定すれば
パターンでオブザベーションの抽出ができるわけです。

他にたくさん記号や書き方があるので、そこを勉強すれば、相当柔軟なマッチングができるわけです。

ちなみに

data A2;
 set Q1;
  Y=PRXMATCH('/¥d{3}-[x-z]{2}/i',X);
run;

とすると、大文字小文字の違いが不問化され

となります。


ちなみにただ、一致した位置を返すだけがSAS Perl正規表現ではありません。

以下のプログラムと結果をみてください

data A3;
set Q1;
 Y1=PRXCHANGE('s/23-/いろ/',1,X);
 Y2=PRXCHANGE('s/23-/いろ/',2,X);
 Y_1=PRXCHANGE('s/23-/いろ/',-1,X);
run;


これは変数の中に出現する、「23-」というパターンを「いろ」という文字列に置き換える処理です。
置換にはPRXCHANGE関数と正規表現の部分の/前にsをつけます。

第2引数は、見つかったパターンの何個目まで置換対象にするかという数字です。

ここを-1にすると、1個だろうが100個だろうが、全部置き換えるという処理になります。


多分、ここまでで、なんかこれって、もっと凄い柔軟で複雑なテキスト処理ができるんじゃないか?
と感じていただければ幸いです。
正規表現を極めれば、対テキストデータのプロになれます。
多分テキストマイニング等をされる方は、使う方多いんではないでしょうか?

/*追記*/
コメントにて、とても大切なテクニックについてご教示いただきました。有難うございます!


文字型に入っている数字のデータをproc sortする時に、数字とみなして並び替える

sortプロシジャはソートアルゴリズムや、ソートの順序規則を変えることができ、奥が深すぎるので、
実用的なテクニックだけ1つ紹介します。

data Q1;
length X $2;
X='1';output;
X='3';output;
X='5';output;
X='9';output;
X='11';output;
run;


これをXをby変数にしてソートすると、どうなるでしょうか?

proc sort data=Q1 out=A1;
 by X;
run;

以下のようになります


えっ!と思われた方もいるかもしれませんが、Xは文字型なので、言葉として辞書的にソートされちゃうイメージです。

なので数値的にソートしたければ、一端、数値に変換した変数を新しく割り当ててから、それでソートします。
しかし、やりたいことが単純な並び替えだけなのであれば、なんだか一手損な感じがしてしまいます。

そこで、ソートルールをいじくります。

proc sort data=Q1 out=A2
 sortseq=linguistic(numeric_collation=on);
 by X;
run;


青字の部分はかなり色々な書き方ができるので深入りしたい方は調べてみてください。