optionsでobs=やfirstobs=を指定することで、以降に発生する全てのデータの読み込みに対して、強制適応させる技。使途不明

なんか応用すれば、面白そうなことができそうなオプションなのに、遊び方が思いつかないので
どなたか。

通常

data A;
 set B(firstobs=3 obs=8);
run;

とするとBの3オブザベーション目から8オブザベーション目までを、setの対象にすることができます。

proc print data=Q1(firstobs=3 obs=8);
var X;
run;

のようにプロシジャに流すデータにも使えます。

通常、でかすぎるデータを試しに回したり、一部分だけprintしてチェックする時などに部分的につかうオプションです。

が、実はoptions で指定することで、それ以降に発生する全てのステップに適応されます。

つまり

options firstobs=3 obs=8;

data Q1;
 do X=1 to 30;
  output;
 end;
run;

data Q2;
 set Q1;
run;

data Q3;
 set Q2;
run;

data Q4;
 set Q3;
run;

proc print data=Q1;
var X;
run;


とすると
【Q1の中身】


【Q2の中身】


【Q3の中身】


【Q4の中身】


【proc printの結果】


な感じです。

options firstobs=min obs=max;
がデフォルトみたいです。


do to by ループのtoを消してもループは成立するので、それを使って1手得を狙っていく話

以前、「do until(end変数)set end=を利用して、複数のデータステップを1つにまとめて共存させる方法」
http://sas-tumesas.blogspot.jp/2013/12/do-untilendset-end1.html

で、do loopの中にsetコマンドを突っ込むやりかたを紹介しました。

また、その方法については「SASインタリーブ(interleave)の紹介と再帰的インタリーブで、SQL再マージ処理をデータステップで疑似的に表現する」
http://sas-tumesas.blogspot.jp/2014/01/sasinterleavesql.html

でも少しふれましたし

最近、「詰めSAS10回目_変数内の1文字ごとにオブザベーションを起こす」でa matsuさんが
提案してくれた方法もdo ループとsetをつかっています。
http://sas-tumesas.blogspot.jp/2014/01/sas101.html


で、これとほぼ同じ内容にはなるのですが
ループの中でカウンタとする変数を増加する場合、
ループの中で変数+1と割り当てる方法があるのですが、最近、それを省略してもかけるんじゃないかと思いつきました。

ちょっと細か過ぎて、この話題で喜ぶ人がどれくらいいるか謎ですが、

たとえば

data Q1;
X='A';output;
X='A';output;
X='Z';output;
X='B';output;
X='Z';output;
X='A';output;
X='B';output;
X='C';output;
X='Z';output;
run;


こういうデータがあって、
Xの値に「Z」が出現するまでのオブザベーション数をカウントし、出現した行の番号と
ともに出力するというプログラムをかくとします。

求めたい結果は


元データの3,5,9行目でZが出現しているのでROWには3,5,9が入り、
そこまでに出現するZ以外の文字のカウントがCOUNTに入ります。


さて、どう切り込みますか?

今回の場合、元データの格納順を崩せないので
ソートを利用したfirst last系の分岐を利用できないんですね。

多分、第一感はretainだと思います。

data A0;
 set Q1;
 retain COUNT 0;
 COUNT+1;
 if X='Z' then do;
  ROW=_N_;
  output;
  COUNT=0;
 end;
drop X;
run;

で詰みですね。

これでも全然いいんですが、do loopを使うなら

data A1;
 do COUNT=0 by 1;
  set Q2;
  ROW=monotonic();
  if X='Z' then leave;
 end;
 drop X;
run;


これでも詰みなんです。

do loopの to条件を省くことでループ変数そのものをカウンタ変数として使っちゃうわけですね。
setがループされるため、ここで_N_つかっても1,2,3とはいるだけで元データの行番号をとるうえではポンコツなのでmonotonic関数でとります。
ちなみにここでのleaveはoutputでもいいです。leaveでもオブザベーション起きるのが面白いので
leaveにしてます。

ちなみにifで抜けなくても、until終了条件でも当然OK

data A2;
 do COUNT=0 by 1 until(X='Z');
  set Q2 end=eof;
  ROW=monotonic();
 end;
 drop X;
run;


詰めSAS12回目:キーが一致しないものを残すマージ(共通部分を除く結合)の話

タイトルで意味がわかりますでしょうか?うまく説明できません


ベン図で書くと、上の黄色の部分です(ペイントで適当に書いたベン図なので、○の大きさが違う、、)

例えば

data Q1;
do X=1,3,4,6;
 output;
end;
run;


data Q2;
do X=1,3,5,6,8;
 output;
end;
run;


のようなデータセットがあった場合に1つのデータセットにしかないXの値をもった結果


を得るには、どんなコードを書けばいいでしょうか?


ただし、MergeステートメントとSQL両方のやり方で詰ませないといけないというのが
今回の問題です。


え?第一感楽勝!と思われるかもしれませんが、案外、つまづきませんか?
実際、このタイプの結合処理って、頻度少ない気がします。

大体は両方一致するものを残すか、片方を全部残して結びつくものを残す、いわゆる内部結合や片側外部結合が大半ですよね。

実は今回も自分の解答に自信がなくて、もし間違いや、抜け穴、最適じゃない書き方であれば
ご指摘いただけると助かります。


以下、(一応)解答


【MERGEの場合】

data A1;
 merge Q1(in=ina)
       Q2(in=inb);
 by X;
 if ^(ina*inb);
run;

こんな感じでしょうか?

ifのところは (ina=1 and inb=0) or  (ina=0 and inb=1)みたいな感じでもいいですし
^(ina and inb)でも、ようはin=で指定した変数が全部1になるケースを除く書き方をしていれば
なんでもいいです。


【SQLの場合】

proc sql noprint;
 create table A2 as
  select coalesce(Q1.X,Q2.X) as X
  from Q1 full outer join Q2
       on Q1.X=Q2.X
 where ^Q1.X | ^Q2.X;
quit;


こんな感じでしょうか?
完全外部結合がみそですね。

わかりやすくするために、create tableとりはずして
where句で Q1.X=0 or Q2.X=0 をしている部分も外しましょう(|はorを意味する記号)

proc sql;
  select Q1.X  label='Q1のX'
         ,Q2.X label='Q2のX'
  from Q1 full outer join Q2
       on Q1.X=Q2.X;
/* where ^Q1.X | ^Q2.X;*/
quit;

こうしたら


こうなるので、これをみれば、上のコードも理解しやすいはずです。
どっちかが欠測の場合を抽出しているんで、最初に見つけた欠測以外の値を取得する
coalesceが効いいるわけですね。


あ、ちなみに、僕が最初に思いついたSQLは

proc sql noprint;
 create table A3 as
  select X from Q1
   union all corr
  select X from Q2
  
  except

  select coalesce(Q1.X,Q2.X) as X
  from Q1 innner join Q2 on Q1.X=Q2.X;
  ;

quit;

です。まあ、確かにベン図を表現していなくはない、気持ちはわからなくはないと思っていただければ浮かばれます。


リンクさせていただいたサイト様

ここ最近で、SAS関連の情報を発信されているサイト様に多くリンクを貼らせていただきました。普段、私が参考にさせていただいているサイト、またSASを最初に学習する際に特にお世話になったサイトになります。
リンクさせていただきましたサイト様にはここで改めて御礼申し上げます。

アクセス解析などはよくわからないのですが、最近、検索されたワード一覧みたいなやつを見てみると、結構、統計解析の知識を求めて、僕のサイトに迷い来てしまった方も多いようです。
普段、読んでいただいている方はおわかりかと思いますが、僕のブログから、統計解析の理論について学べる部分は限りなくゼロに近いので心苦しかったです。

また、SASを最初に覚える際の学習にも、このブログは向いてないと思います。とりあげる話題に脈絡がなく、気の向くままに、ちょっとマニアックなことばかり紹介しているので、、。申し訳ないです。

やはり、その人によって、SASといっても、必要とされている知識の種類に差があるようです。海外であれば、適当に検索してても、情報が多いのですぐにたどり着けそうですが、日本の場合は、なかなか求めるべき情報があるページを探しきれないことが多い気がします。

なので、いい出会いが多くなって、日本のSASがもっと活発になれば嬉しいなぁと思って僭越ながら様々なサイト様にリンクさせて頂きました。

今後もぜひ増やしていけたらと思います。これから新しくブログを立ち上げる方もぜひ相互にリンクさせていただけたら嬉しい限りです。


indsname定跡

indsname=オプションが気になっていて、面白そうだから、何かの処理に活用したいんだけど、いい使い道がわからないので教えてくださいというご連絡を匿名で直接いただきました。

手段のために目的を探すその姿勢、僕は大好きです、とても共感します。

というわけで、僕の中で定跡となっているindsnameを使った手順を紹介します

あ、ちなみに以前のindsname=の記事は
http://sas-tumesas.blogspot.jp/2013/10/indsname.html
です。


さて、今、WORKの中にたくさんのデータセットがあったとします。

data Q1;
ID='0001';output;
ID='0002';output;
ID='0003';output;
ID='0001';output;
run;

data Q2;
ID='0006';output;
ID='0002';output;
ID='0004';output;
ID='0003';output;
run;

data Q3;
ID='0005';output;
ID='0002';output;
ID='0004';output;
ID='0003';output;
run;

data Q4;
ID='0005';output;
ID='0001';output;
ID='0004';output;
ID='0003';output;
run;

data Q5;
ID='0001';output;
ID='0001';output;
ID='0001';output;
ID='0003';output;
run;


さて、これらのデータセットの中で変数「ID」の値が0001のデータを含むデータセットの名前と
0001のデータのオブザベーション数を抽出したデータセットを作成しなさいと言われたら、
どういった処理を書くでしょうか?

要するに求めたい結果は


こんな感じです。

やり方はたくさんあると思いますが、僕はこういったケースの場合

data ALLDS;
 set Q: indsname=NAME;
  DSNAME=scan(NAME,2,'.');
run;

proc freq data=ALLDS noprint;
 tables DSNAME*ID/out=A(drop=percent ID);
 where ID='0001';
run;

こう書きます。

2ステップですが、わかりやすいです。

freqに書ける前のALLDSの中身は


こんな感じです。


これって結構応用が利いて、
複数のデータセットを対象として、何か条件をかけて
その結果とデータセットの名前を、結果としたデータセットを作りたい時にわかりやすいです。

GLOBALのユーザー会でも、まだほとんど見かけないので、開拓の余地があるオプション
だと思います。テーマにするなら狙い目じゃないでしょうか。


ODS Graphics Editorの話 (特別なライセンスなし、SAS/GRAPHでできる便利な機能)

templateプロシジャで、Glaph Template Languageで、グラフのテンプレートを作って、proc sgrenderでそのテンプレートを指定して、プロットする。

SAS9.2以降、SG系グラフの登場により、グラフの表現力はケタ違いにアップしましたが、その代わり、最初のハードルも随分高くなってしまった気がします。

いきなりGTLガリガリ書いてグラフを作るのは、ちょっと難しいので、最初のうちは
SASのグラフサンプル集http://support.sas.com/sassamples/graphgallery/PROC_SGRENDER.html

やSASユーザー総会で公開されているものや、或いは書籍、コピペして、少しずつカスタマイズして
自分のものにしていくのがいいと思います。
リンクさせていただいている「僕の頁 <SASと臨床試験と雑談と>」(http://sasboku.blog.fc2.com/)
にもGTLを使ったプロットが公開されていて勉強になります。

で、今回紹介するのは、それとは違ったアプローチです。
GUI、ようはプログラムを書かずに手でグラフを書いて、それを自動的にコード化する話です。

まず、適当なデータをつくります。

data TEST;
call streaminit(2014);
do GROUP='A','B';
 do i=1 to 100;
  x=rand('uniform');
  y=rand('uniform');
  output;
 end;
end;
drop i;
run;


そしたら、まず、SASをインストールする時に、ODS Graphics Editerにチェックをつけた人は、すでにアイコンがあるか、すべてのプログラムから立ち上げられるので、そうしてください。


もし、そういったものが見当たらない人は

%sgdesign;

とエディタに書いて、実行してください。
何かが裏で凄い動いた感じがして、10数秒後、


こんな画面がでてきます。

ここで、いろんな形のグラフを選ぶことで、実は相当高度なグラフもかけます。


試しにグラフギャラリーから「グループ化散布図」でも選んでみましょう


グラフを選ぶと、次はグラフに使うデータセットを指定します。
デフォルトがなぜかSASHELPなので、参照元にするライブラリを指定します。


※ちなみにここで、%sgdesign;で起動した人は、WORKの中をみてみましょう。
わけわかんないデータセットであふれているはずですが、これは、グラフを書くサンプル用の
データセットを勝手に用意してくれいるんです。迷惑です。


で、最初につくったデータセットを指定します


そしたら


X軸に対応する変数とY軸に対応する変数、そしてグループ化する変数をプルダウンで
選びます。

そしたら、それだけで、グラフがポンとでてきます。
で、なんと、そのグラフを手で修正できます。

まずはグラフタイトルをクリックして、好きなタイトルにします


右クリックで、軸や背景などのいろんなプロパティをいじれます。
感覚的にはEXCELのグラフを編集するのと全く同じです。

背景色を灰色にしてみました。


要素の追加で、さらにプロットを重ねたり
フリーテキストや凡例などを追加できます


凡例を追加してみました


やりたい放題やって、気がすんだら、ここからが本番


表示から「コード」をクリックすると
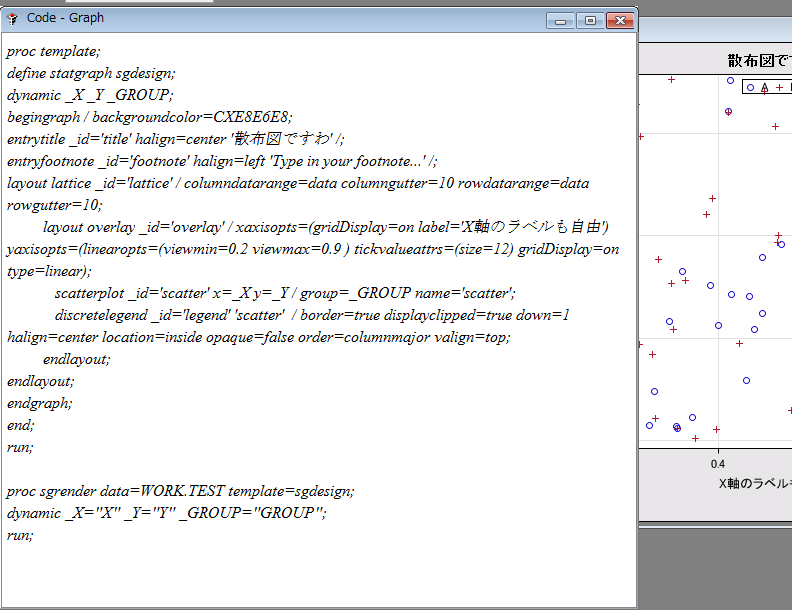


なんと、proc templateでのテンプレート定義から
proc sgrenderの実行までを全てコード化してくれます。


プロットに指定した変数はdynamicステートメントで受け渡すことを想定したコード化を
してくれるので、標準化もしやすく、超便利。

あとはこれをエディタにペタ

proc template;
define statgraph sgdesign;
dynamic _X _Y _GROUP;
begingraph / backgroundcolor=CXE8E6E8;
entrytitle _id='title' halign=center '散布図ですわ' /;
entryfootnote _id='footnote' halign=left 'Type in your footnote...' /;
layout lattice _id='lattice' / columndatarange=data columngutter=10 rowdatarange=data rowgutter=10;
         layout overlay _id='overlay' / xaxisopts=(gridDisplay=on label='X軸のラベルも自由') yaxisopts=(linearopts=(viewmin=0.2 viewmax=0.9 ) tickvalueattrs=(size=12) gridDisplay=on type=linear);
            scatterplot _id='scatter' x=_X y=_Y / group=_GROUP name='scatter';
            discretelegend _id='legend' 'scatter'  / border=true displayclipped=true down=1 halign=center location=inside opaque=false order=columnmajor valign=top;
         endlayout;
endlayout;
endgraph;
end;
run;

proc sgrender data=WORK.TEST template=sgdesign;
dynamic _X="X" _Y="Y" _GROUP="GROUP";
run;

で実行するだけで

さっきまで、手でいじって作ってたグラフが、ポンです。


これは、GTLを勉強するとき、何と何が結びついているかを理解する上でも、大変役立ちますね。
レイアウト分割の複合グラフを、一からコードで起こすのは、まあ、なかなか、つらいですよね、それはそれで勉強になるけども


inとコロン(:)の合わせ技、文字型に対する接頭一致

リンクサイト「SAS忘備録」で
「条件式(IF/WHERE)におけるINオペレータの小技」
http://sas-boubi.blogspot.jp/2014/01/in.html

の中で

data DT1;
  do V=1 to 6 ;
   output;
  end;
run;
proc print data=DT1 noobs;
 where  V in (1, 3 : 5) ;
run;

とすると


となるように、inの中での3:5が3~5の範囲指定として実行されるという技を紹介されていました。

今回は、文字型について、括弧の中にコロンを入れるのではなく外に出したら、どうなるかを見てみます。

data Q1;
length X $20.;
X='ABCD';output;
X='ABCDEF';output;
X='DEFG';output;
X='AB';output;
X='BBC';output;
X='DBC';output;
run;


こういうデータがあって

data A1;
 set Q1;
 where X in:('ABC','DE','DB');
run;

としたら、どうなるでしょうか?

答えは


です。
これはつまり、Xの値がABCから始まるか、DEから始まるか、DBから始まる場合に抽出しているということです。

keepやdropステートメント等で X_:とするとX_から始まる変数名の変数が対象になったり
set X_:とするとX_から始まるデータセット名のデータセットが対象になったりするのと同じ
前方一致を意味するコロンな使い方です。

なんでinじゃなくて

data A2;
 set Q1;
 where X=:'ABCDE';
run;

でも使え、


こうなります。

コロンは色々使える分、ややこいですね