全てがnullであった時を問題とするブランクチェックについて、データ構造が縦型と横型であった場合の違い

生データをチェック・クリーニングする際に、ブランクチェックは頻度の高い処理です。

たとえば今A,B,Cという変数があって、どれか1つ以上でも値が入っていれば、問題なし。
全てが欠損値であるデータをピックアップしたいという状況があったとします。

例えばデータが

data Q1;
IDNO='001';A=.;B=.;C=10;output;
IDNO='002';A=.;B=.;C=.;output;
IDNO='003';A=5;B=.;C=.;output;
run;


こんな感じならwhereで単純に=.をandでつないでもいいし

data A1;
 set Q1;
 if coalesce(A,B,C)=.;
run;

こんな感じでもいいし、簡単です。


少し頭を使うのは、同じ意味であってもデータ構造が

data Q2;
IDNO='001';ITEM='A';VAL=.;output;
IDNO='001';ITEM='B';VAL=.;output;
IDNO='001';ITEM='C';VAL=10;output;
IDNO='002';ITEM='A';VAL=.;output;
IDNO='002';ITEM='B';VAL=.;output;
IDNO='002';ITEM='C';VAL=.;output;
IDNO='003';ITEM='A';VAL=5;output;
IDNO='003';ITEM='B';VAL=.;output;
IDNO='003';ITEM='C';VAL=.;output;
run;


こういう場合です。
1つのIDにつき項目ごとにオブザベーションが別れています。
問題にすべきはA,B,C全てが欠損である002のIDで、それを特定したいわけですが、
さて、どう書きましょうか?

まず1つとしては

proc transpose data=Q2 out=Q2_(drop=_NAME_);
 var VAL;
 by IDNO;
 id ITEM;
run;

とすれば、最初の問題のデータ構造に転置されるので、そうしてから
同じやり方で片付ける方法です。

縦に解く問題が難しければ、横にすればいいし
横に解く問題が難しければ、縦にすればいいというのはSASの定跡ですね。

まあ、でもこの場合、わざわざデータ構造を変えなくても
例えば、

proc means data=Q2 nway noprint;
class IDNO;
var VAL;
output out=A2(where=(S=.)) sum=S;
run;


このようにすれば、IDごとにAからCの合計をだしてくれるわけですが
sumによる加算結果がnullになるのはどんな時でしょうか?
それは対象全てがnullであったときのみです。その他の場合はnullを除いて足し算してくれます。
すなわちsumがnullであればA,B.Cすべてnullであることに他ならないので
上記のコードでID 002を特定できるわけです。
maxとかでももちろんいいです。


他のアプローチとして、

proc sort data=Q2;
 by IDNO VAL;
run;

data A3;
 set Q2;
 by IDNO VAL;
 if last.IDNO and VAL=.;
run;


もアリですね。

ID順、VAL順にソートして、各IDの最後のVALがnullである場合は、そこまでの全てのVALがnullであることと同義ですからね。


筋悪ですが、LINKステートメントとGOTOステートメントについて

SAS Technical News 2010 Autumn 「意外と知らない!? コロンの活用術をご紹介」は僕のお気に入りの号のひとつです。

http://www.sas.com/offices/asiapacific/japan/periodicals/technews/index.html#section=4

SASにおけるコロン「:」はトリッキーかつ結構いい働きをするやつで、これをうまく使えるかどうかで、コードの完成度に差がでると思っています。僕の中では桂馬みたいなイメージです。

で、だいたい上記の号の中でコロンの使いどころについて言及されているのですが、ちょっと勝手に感じたのが、やっぱりSAS的にはLINKステートメントやGOTOステートメントにおけるラベルコロンは紹介すべきではないと考えているのかなということでした。

LINKやGOTOステートメントは、プログラムの途中で指定箇所(ラベルといわれる)にぶっ飛ぶことができる危ない奴です。

GOTO文は筋悪というのは、多くのプログラム言語に当てはまることで、SASにとっても
上から下に流れるSASのシンプルな処理をぶち壊す、やっかいなステートメントです。

恐らく、ほぼ全てのケースにおいてGOTOやLINKを使わずに、目的の処理が果たせるコードはかけるはずなので、使用はお勧めしません。

ただ、コードを書く人も、読むであろう人も全員、熟練者であれば、相当複雑なネストを組む時に、全体をすっきりさせるために使用することはあるのかもしれません。

しかし、もしかしたら、運悪く、どこかで他人の書いたGOTO や LINKのコードに対峙することがあるかもしれません。そんな時の対抗手段として、基本的な挙動は知っておいて損はないと思います。

例えば以下のようなデータセットがあったとします。

data Q1;
do X=1 to 5;
 do Y=2 to 4;
  output;
 end;
end;
run;


これに対して以下のコードを実行すれば

data A1;
 set Q1;
 by X;
 if first.X then Z=0;
  Z+Y;
run;


となります。


これをLINKステートメント使って表現すると

data A2;
 set Q1;
 by X;
 if first.X then link FL;
  Z+Y;
 return;

 FL:
  Z=0;
 return;
run;

となりますFLというのがジャンプ先の目印になって
そこからジャンプ先での処理が行われて、returnで戻ってきます。

ちなみにlinkの部分をgotoにすると

data A3;
 set Q1;
 by X;
 if first.X then goto FL;
  Z+Y;
 return;

 FL:
  Z=0;
 return;
run;

returnで停止するので


僕が知っているのも、ほんとこの程度までです。


LIBNAME EXCELで「予期しないエラー~」とでる場合はファイルの属性をチェックし、access=readonlyで解決する場合がある

最近で直接いただいた質問のうち、2件同じ症状で、同じ解決法で解決した事例の紹介です。

libname EXCELでlibnameステートメントを実行した時点で以下のような


ERROR: Connect: 外部データベース ドライバ (????????) で予期しないエラーが発生しました。

や

ERROR: Connect: 外部データベース ドライバ (am Files\Common Files\Microsoft Shared\OFFICE12\ACECORE.DLL) で予期しないエラーが発生しました。

といったエラーメッセージがでる場合、EXCELファイルのプロパティの属性が
「読み取り専用」となっている可能性があります。


その場合libnameステートメントに

libname XX "----------" access=readonly;

と読み取り専用でライブラリ指定しないと上記のエラーになります。
エラーメッセージから意味が読み取りにくいのはいつものことですが、これも気づきにくい
エラーですね。

読み取り専用のチェックはずしてもいいなら外してもOKです。


do i=1 to ○○ until();のようにdo toループとuntilやwhileが併用できることを今まで知らなくてとても悲しかった話

とてもショックです。

data A1;
X=20;
 do i=1 to 99 until (X=40);
  X+2;
 output;
end;
run;

99回ループする。ただし途中終了条件としてX=40になれば終了する。
この処理を上記のコードでかけるのです。
こんな単純な書き方なのに気づきませんでした。ショックです。悲しいです。

以前は以下のように書いていました。

data A2;
X=20;
 do until(i=99 or X=40);
  X+2;
  i+1;
 output;
end;
run;

最近、leaveステートメントを知って、その時もショックでしたが、
以来、以下のように書けるようになりました。

data A3;
X=20;
 do i=1 to 99;
  X+2;
  output;
  if X=40 then leave;
end;
run;

SASのデータステップの知識の全てを100としたら、多分そのうち理解できている部分は
1以下だろうと思い知りました。

性根を叩き直して勉強しなおします


n個の変数からm個の変数を選択する、組み合わせのデータセットを作成する方法

「い」「ろ」「は」「に」という4つの値から2つを選ぶ場合、組合せの数は
4C2で6通りになりますが、その組み合わせを1組み1オブザベーションとしてデータセットを作る場合、たとえば以下のようにかけます。

data A1;
   array X(4) $ ('い' 'ろ' 'は' 'に');
   do i=1 to comb(dim(X),2);
      call allcomb(i, 2, of X(*));
 keep X1 X2;
      output;
   end;
run;


まずcomb関数は組合せ数を返します、dim(X)つまり4から2をとる組合せ数、つまりここが
6になります。

作成したいデータセットは6オブザベーションになるはずのなので1から6までのループをかけ

allcombルーチンをかけます、ここでの第1引数は作成された各組合せに振られた連番で
1から6すべて選択してoutputすることで全組み合わせをデータに起こせます。
2つの変数しか必要ないので第3,4要素の変数をdropします。


また例えば、全順列が欲しい場合は階乗をかえすfact関数と
allpermルーチンで、以下のようにできます。

data A2;
   array X(4) $ ('い' 'ろ' 'は' 'に');
   do i=1 to fact(dim(X));
      call allperm(i, of X(*));
 drop i;
      output;
   end;
run;


ちなみに1000個の変数をallpermルーチンに指定したら、天文学な数字になって
永遠に処理終わらなくなんのかなと思って、よし、SASよ永久無限に働くがよい!と思って
ためしにやってみると


「ERROR: ALLPERMルーチンは20個を超える変数を並べ替えることはできませんが、
       1000個の変数が指定されました。
 ERROR: 内部エラーが関数ALLCOMBに検出されました。DATAステップは、
       EXECUTIONフェーズで終了しました。」

とSASにしっかり咎めていただきました。


ユークリッドの互除法で最大公約数をだすコードを一生懸命書いた後で、GCD関数とLCM関数を紹介して、便利になったなぁと感謝する話

言語を問わず、プログラミングのチャレンジ問題でよくでてくる「ユークリッドの互除法」を紹介します。

「ユークリッドの互除法(ユークリッドのごじょほう)は、2 つの自然数または整式の最大公約数を求める手法の一つである。2 つの自然数(または整式) a, b (a ≧ b) について、a の b による剰余を r とすると、 a と b との最大公約数は b と r との最大公約数に等しいという性質が成り立つ。この性質を利用して、 b を r で割った剰余、 除数 r をその剰余で割った剰余、と剰余を求める計算を逐次繰り返すと、剰余が 0 になった時の除数が a と b との最大公約数となる。」
(Wikipediaより転載)

最小公倍数についてはa*b/(aとbの最大公約数)でだせるので省略します。

これをSASで書くなら

data _NULL_;
 X=1029;
 Y=1071;
 call sortn(X,Y);
  MD=mod(Y,X);
  ANSWER=X;
 do while(MD^=0);
  MD_=MD;
  MD=mod(Y,MD);
  Y=MD_;
  ANSWER=Y;
 end;
 put '最大公約数は' ANSWER;
run;


上記の感じでしょうか?XとYの値を色々変えてみてください。
call sortnルーチンで横ソートしているので、大小関係を気にせず指定できます。

要は余りが0になるまで、割ってけばいいんですね。
でも実際、アルゴリズムはわかっていても、コードにおこすのは、結構大変ですよね。


ところが9.2からgcd関数で最大公約数をl㎝関数で最小公倍数を簡単にだせるようになりました。
複数変数指定も可能で、もう二度とデータステップでループ書く必要がなくなりました。

data _NULL_;
ANSWER1=gcd(1029,1071,63);
ANSWER2=lcm(8,3,5);
 put '最大公約数は' ANSWER1;
 put '最小公倍数は' ANSWER2;
run;


詰めSAS11回目:集計データセットを集計前の状態に戻す

今回の詰めSASは、超簡単なので1分以内の早解き問題です。

今、以下のデータセットがあったとします。

data Q1_;
X='い';output;
X='い';output;
X='い';output;
X='い';output;
X='ろ';output;
X='ろ';output;
X='ろ';output;
X='は';output;
X='は';output;
run;


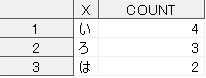
これに対してFREQプロシジャをかけて、OUTでだしたデータセットが以下です。

proc freq data=Q1_ noprint order=freq;
tables X/out=Q1(drop=percent) ;
run;


data Q1;
X='い';COUNT=4;output;
X='ろ';COUNT=3;output;
X='は';COUNT=2;output;
run;


このデータセットを、最初の状態に戻すプログラムを書いてください。


【解法】

data A1;
 set Q1;
 do i=1 to COUNT;
  output;
 end;
drop i COUNT;
run;