Raincloud plot「序章」

OpenResearchの,こちらの論文を読んで凄く感銘をうけました

Raincloud plots: a multi-platform tool for robust data visualization 

https://wellcomeopenresearch.org/articles/4-63

Raincloud plotへの並々ならぬ愛もなんですが,データビジュアライゼーションへの真摯な知見もですし,なによりWebコミュニティの集合知を最大限に活用しており,非常にいいなと.

だけど,まあ,しょうがないんですけど,SASで描いたバージョンはないのです(笑)

ということで,今年の某総会の発表ネタの1本はRainCloud PlotにSASバージョンの彩りを加えるにしようかなとか思ってます


個別の値にマウスオンしたら,どのサンプルで,どんな値かもバッチリ表示
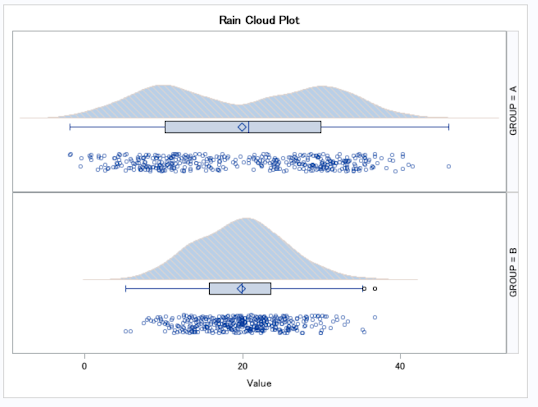


まだまだここから磨いていかねばと思ってますがとりあえず.
datalatticeとprototypeでカテゴリ分割してますが,次は時系列で,代表値推移を線で結んで雷にみたてたバージョンもやりたいので,それだと今のやり方だとまずいですからね
また考えようかなと思ってます

%let outpath=XXXXX;


/*Test dataset*/

data test;

call streaminit(1080);

GROUP="A";

do id=1 to 200;

        val=rand("normal",10,5);

        output;

end;

do id=201 to 400;

        val=rand("normal",30,5);

        output;

end;

GROUP="B";

do id=1 to 200;

        val=rand("normal",18,5);

        output;

end;

do id=201 to 400;

        val=rand("normal",22,5);

        output;

end;


run;


/* calculation----kernel density estimation*/

proc kde data = test ;

 univar val /out=kde ;

 by GROUP;

run;


/* calculation----for box-and-whisker*/

ods _all_ close;

ods output SGPlot=box;

proc sgplot data=test;

 vbox val/group=group;

run;

ods html;


/*dataset-fix*/

data wk2;

set kde(in=ina)

     box(in=inb where=(^missing(BOX_VAL_GROUP_GROUP____Y)))

     test(in=inc)

;

call streaminit(0615);

if ina then low=0;

if missing(BOX_VAL_GROUP_GROUP___ST) then BOX_VAL_GROUP_GROUP___ST="DUMMY";

if ^missing(BOX_VAL_GROUP_GROUP___GP) then group=BOX_VAL_GROUP_GROUP___GP;

if inb then dummy_x=-0.01;

if inc then do;

    dummy_y=-0.05;

    random=rand("uniform")*0.01;

    if ranuni(777)<0.5 then dummy_y=dummy_y - random;

    else dummy_y=dummy_y + random;

end;

run;


/*Plot-define*/

ods graphics on /imagemap=on tipmax=5000;

ods html path="&outpath" file="test.html";

proc template ;

  define statgraph RCP ;

     begingraph;

          entrytitle "Rain Cloud Plot";

           layout datalattice rowvar=group/  columnaxisopts=(label="Value") rowaxisopts=(display=none);

              layout prototype;

                   bandplot x=value limitupper=density  limitlower=low / display=all ;

                   boxplotparm y=BOX_VAL_GROUP_GROUP____Y x=dummy_x   stat=BOX_VAL_GROUP_GROUP___ST /boxwidth=0.3 orient = horizontal  ;

                   scatterplot x=val y=dummy_y/ jitter=auto jitteropts=(axis=Y width=1) markerattrs=(symbol=circle size=8 transparency=0.4)

                    rolename=(tip1=ID tip2=VAL) 

                    tip=(tip1 tip2)

                    tiplabel=(tip1="ID" tip2="Value")

                    ; 

              endlayout;   

           endlayout;

     endgraph;

  end;

run;

/*Plot-submit*/

proc sgrender data=wk2 template=RCP ;

run;

ods html close;


RTF帳票で脚注が長くて,本体部分の合計のセル幅を超えて,見栄えが悪くってしまう時の対策


ちょっとマニアックな話.
治験分野の内輪話になっちゃうかもですが,英語で解析帳票作ることが増えて,略語を脚注に入れたり,1帳票内での情報の完結といった観点から,なんか昔より解析についての脚注記載も多くなった気がします

上記のRTF出力は

ods escapechar="~";
options orientation=landscape;
ods rtf file="test.rtf"; 
proc odstable data=sashelp.class(where=(monotonic()<=5)); 
  column name age ;
  define header header1; start=name; end=name; text "AAAA";end;
  define header header2; start=age; end=age;    text "BBBB";end;
  define footer MYFOOT1;  just=left; style={borderbottomstyle=hidden borderrightstyle=hidden  borderleftstyle=hidden  background = white}; text "寿限無寿限無五劫の擦り切れ海砂利水魚の水行末雲来末風来末食う寝る処に住む処藪ら柑子の藪柑子パイポパイポパイポのシューリンガンシューリンガンのグーリンダイグーリンダイのポンポコピーのポンポコナーの長久命の長助"; end;
  define name; print_headers=off; just=left;   style={cellwidth=30mm};end;
  define age; print_headers=off; just=center; style={cellwidth=20mm};end;

run;
ods rtf close;


で描いたのですが(罫線などのスタイル制御は通常,別途templateプロシジャで作っておきますが,今回は本筋ではないので,長くなって申し訳ないですがodstable内ですませてます),これだと脚注が,レポート本体部分のnameとageの出力セルの合計幅に制限されてしまい,折り返しが多くなります.帳票全体の右側に余裕がある場合,ここでコンパクトに折りたたまれて,縦伸びされると見た目がバッド.

プロシジャの出力をつかわずods rtftextとかで別途出すのも一つの手ですが,

 startpage=noなどで1ページ内複合表を作ってる場合などではods rtftextだと不可避の1行空行が生じたりとか,具合悪い場合も多く,やっぱりodstableのfootnoteで出したいなぁってこともあったりします

その際に,正解なのは不明で,もっといい方法があれば教えて欲しいのですが

ods escapechar="~";
options orientation=landscape;
ods rtf file="test.rtf";
proc odstable data=sashelp.class(where=(monotonic()<=5)); 
  column name age  gap;
 define header header1; start=name; end=name; text "AAAA";end;
  define header header2; start=age; end=age;    text "BBBB";end;
  define header gaphed;  start=gap; end=gap; style={background = white borderbottomstyle=hidden bordertopstyle=hidden borderrighttyle=hidden}; text " "; end;
  define footer MYFOOT1;  just=left; style={borderbottomstyle=hidden borderrightstyle=hidden  borderleftstyle=hidden  background = white}; text "寿限無寿限無五劫の擦り切れ海砂利水魚の水行末雲来末風来末食う寝る処に住む処藪ら柑子の藪柑子パイポパイポパイポのシューリンガンシューリンガンのグーリンダイグーリンダイのポンポコピーのポンポコナーの長久命の長助"; end;
   define name; print_headers=off; just=left;   style={cellwidth=30mm};end;
  define age; print_headers=off; just=center; style={cellwidth=20mm};end;
  define gap;     compute as (""); style={borderbottomstyle=hidden  borderrightstyle=hidden cellwidth=150mm };                      
run;
ods rtf close;
 
と,データセットにダミーを用意しなくても,プロシジャ内で作ってやって,それに幅を持たせてやれば


こんな感じで,帳票本体を大幅に超えるボリュームの脚注がきても大丈夫っていう感じです.

こっからは余計なお世話ですが,脚注が増えると,目視での整合チェックも量によっては限界があって,ダブルやってるなら補助的にでも脚注もコンペアかけておいた方がいいと思うので,コンペアデータセットに,なんらのカテゴリ変数で抽出できるようにいれておいて
それをodstableに入れる前にマクロ変数にでも吸収させてfootnoteで展開するとか,色々工夫するといいと思います

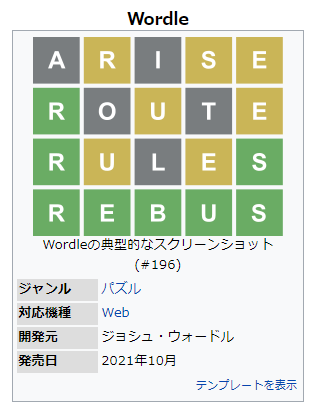
WordleをSASで実装してみた.判定はdo overとhash iterator object), 出力はSAS RWIを使ってみた

 Wordleっていうのが流行っていて,最近,やってる人多いなぁって思ってました
(最初はなんかみんな,謎の図形をSNSにあげてて,なんかの暗号?こわいと思ってました)

いわゆる文字当てゲームで
5文字単語の答えに対して6回チャレンジできるのですが

アルファベットとその位置が回答とあっていたら緑

アルファベットはあってるけど位置が違う場合は黄 って感じで,こちらのチャレンジに対してのフィードバックが返ってくるので,それを手掛かりにできるだけ早く正解に辿り着きましょうってゲームです

詳しくはウィキペディア参照
https://ja.wikipedia.org/wiki/Wordle


昨晩
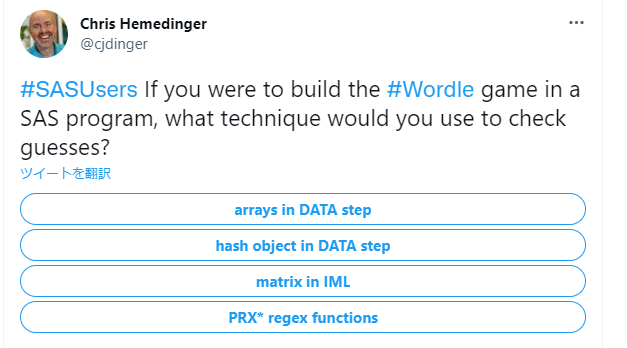
SASユーザーなら何使ってアルゴリズム組むんだ?って海外の方が問いかけました?
Arrayか? hash objectか? IMLか? 正規表現か?

https://twitter.com/cjdinger/status/1503707344907251715


まあarrayが一位だろうと思いつつ,海外はhashの支持率高くていいなぁって,私も第一感hashなんですよね
https://twitter.com/Poswith1/status/1503712048282476544


私の敬愛する方が,こんなこといっちゃうので,色々とお祝いしたいこともあったので
書いてみました

インターフェースをマクロウインドウとかで作ってもよかったんですが
SAS ondemandとかで動かないので,ちょっとそこは手抜き

まず,答えとなる単語をデータセットにしたものを

どっかの永久ライブラリにでもおいておく

data ANS;

NO=1;WD="R";output;

NO=2;WD="E";output;

NO=3;WD="B";output;

NO=4;WD="U";output;

NO=5;WD="S";output;

run;


んで

解答は6回挑戦できるので
まあ,1回答1行ずつ文字いれて実行するイメージで


data DT1;

/*Try-1*/

C1="A";C2="R";C3="I";C4="S";C5="E";output;

/*Try-2*/

C1="R";C2="O";C3="U";C4="T";C5="E";output;

/*Try-3*/

C1="R";C2="U";C3="L";C4="E";C5="S";output;

/*Try-4*/

C1="R";C2="E";C3="B";C4="U";C5="S";output;

/*Try-5*/

C1="";C2="";C3="";C4="";C5="";output;

/*Try-6*/

C1="";C2="";C3="";C4="";C5="";output;

run;


で,肝心の判定と出力部分ですが

解答のデータセットをハッシュ反復子オブジェクト,

挑戦回答を横持ちでdo overでループして

_i_とハッシュの格納Noが一致して,かつデータが一致しているか

データはあるけど_i_とNoが不一致かで判定するようにしました

で,データステップでの判定の流れからダイレクトに美しめの出力を作りたかったので

マイナーですがSASのReport Writing Interface(RWI)オブジェクトを利用してみました


data _NULL_;

length background $50.;

set DT1;

where ^missing(cats(C1,C2,C3,C4,C5));

if 0 then set ANS;

if _N_=1 then do;

declare hash h1(dataset:"ANS",ordered:"Y");

declare hiter hi1('h1');

h1.definekey("NO");

h1.definedata("NO","WD");

h1.definedone();

end;

array  AR C1-C5;

dcl odsout ob();


  ob.layout_gridded( columns:5, rows:1 ,column_gutter: '2mm');

  do over AR;

  position=_i_;

  put position=;

  rc = hi1.first();

  do while (rc = 0);

   if position=NO and AR=WD  then background= "green";

   else if missing(color) and AR=WD  then background= "darkyellow";

rc = hi1.next();

  end;

  if missing(background) then background="gray";

  text=cats(" color=white height=1.5cm width=1.5cm fontsize=5 vjust=center background=",background);

      ob.region();

       ob.table_start();

          ob.row_start();

               ob.format_cell(data:AR,style_attr:text);

          ob.row_end();

       ob.table_end();

   call missing(background);

end;

   ob.layout_end();

 run;


どうでしょう,わりと再現度高くないですかね?
ハッシュ反復子オブジェクトとRWI,両方,データステップ内でのオブジェクトなので
そこで判定とレポートがそのままの流れでできて美しいと感じたのですがどうなんでしょう


SASプログラマにとって大切なこと(Maxims of Maximally Efficient SAS Programmers)

 
PythonZen & PEP 8 検定試験 っていう面白い認定試験があったので受けてみました.
90点(70点ライン)でした. Pythonのコーディングの啓蒙を兼ねた面白い試験でした


PEP8はコーディング規約みたいなもので
PythonZenは心構え的なイディオム集です

1.Beautiful is better than ugly.
2.Explicit is better than implicit.
3.Simple is better than complex.
4.Complex is better than complicated.
5.Flat is better than nested.
6.Sparse is better than dense.
7.Readability counts.
8.Special cases aren't special enough to break the rules.
9.Although practicality beats purity.
10.Errors should never pass silently.
11.Unless explicitly silenced.
12.In the face of ambiguity, refuse the temptation to guess.
13.There should be one– and preferably only one –obvious way to do it.
14.Although that way may not be obvious at first unless you're Dutch.
15.Now is better than never.
16.Although never is often better than right now.
17.If the implementation is hard to explain, it's a bad idea.
18.If the implementation is easy to explain, it may be a good idea.
19.Namespaces are one honking great idea – let's do more of those!

基本的にPythonだけでなく全言語に通じるところのある,まさに「禅」ですね

そういやこういうのの,SAS版ってあったかなぁと思うのですが
Kurt Bremser さんがフォーラムのリーダーもつとめるパワーユーザーで
その方が色んなところで発表されてる
Maxims of Maximally Efficient SAS Programmers
が面白いです
禅は対照的で,なんかマッチョな感じ(本人も)なのですが

https://communities.sas.com/t5/SAS-Communities-Library/Maxims-of-Maximally-Efficient-SAS-Programmers/ta-p/352068


ログ読め,ドキュメント読め,データ見ろ とかほんと,もっともなこといってます
13番とか結構,ぐっときました
「今はそれを学ぶ時間がない」と決して言うな は グサッときますよね

Maxim 13

When you're through learning, you're through.

(Will Rogers, John Wooden)

As long as you keep your ability and will to learn, you are alive. When you stop learning, you may not be dead, but you start smelling funny. Never say "I don't have the time to learn that now". The time to learn is NOW.

"Much have I learned from my teachers, more from my colleagues, but most from my students." - from the Talmud.

Nオブザベーション先の値を取得する話②条件付き先読み

例えば

data temp;

ID=1;time=input("10MAR20:07:51:00",datetime.);val=9;output;

ID=1;time=input("10MAR20:07:52:00",datetime.);val=8;output;

ID=1;time=input("10MAR20:07:53:00",datetime.);val=10;output;

ID=1;time=input("10MAR20:07:54:00",datetime.);val=11;output;

ID=1;time=input("10MAR20:07:55:00",datetime.);val=13;output;

ID=1;time=input("10MAR20:07:56:00",datetime.);val=9;output;

ID=1;time=input("10MAR20:07:57:00",datetime.);val=9;output;

ID=1;time=input("10MAR20:07:58:00",datetime.);val=8;output;

ID=1;time=input("10MAR20:07:59:00",datetime.);val=7;output;

ID=1;time=input("10MAR20:08:00:00",datetime.);val=6;output;

ID=1;time=input("10MAR20:08:01:00",datetime.);val=5;output;

ID=1;time=input("10MAR20:08:02:00",datetime.);val=4;output;

ID=1;time=input("10MAR20:08:03:00",datetime.);val=10;output;

ID=1;time=input("10MAR20:08:04:00",datetime.);val=11;output;

ID=2;time=input("10MAR20:07:51:00",datetime.);val=8;output;

ID=2;time=input("10MAR20:07:52:00",datetime.);val=9;output;

ID=2;time=input("10MAR20:07:53:00",datetime.);val=8;output;

ID=2;time=input("10MAR20:07:54:00",datetime.);val=9;output;

ID=2;time=input("10MAR20:07:55:00",datetime.);val=9;output;

ID=2;time=input("10MAR20:07:56:00",datetime.);val=8;output;

ID=2;time=input("10MAR20:07:57:00",datetime.);val=12;output;

ID=2;time=input("10MAR20:07:58:00",datetime.);val=12;output;

ID=2;time=input("10MAR20:07:59:00",datetime.);val=14;output;

ID=2;time=input("10MAR20:08:00:00",datetime.);val=8;output;

ID=2;time=input("10MAR20:08:01:00",datetime.);val=15;output;

ID=2;time=input("10MAR20:08:02:00",datetime.);val=13;output;

ID=2;time=input("10MAR20:08:03:00",datetime.);val=10;output;

ID=2;time=input("10MAR20:08:04:00",datetime.);val=10;output;

format time datetime.;

run;


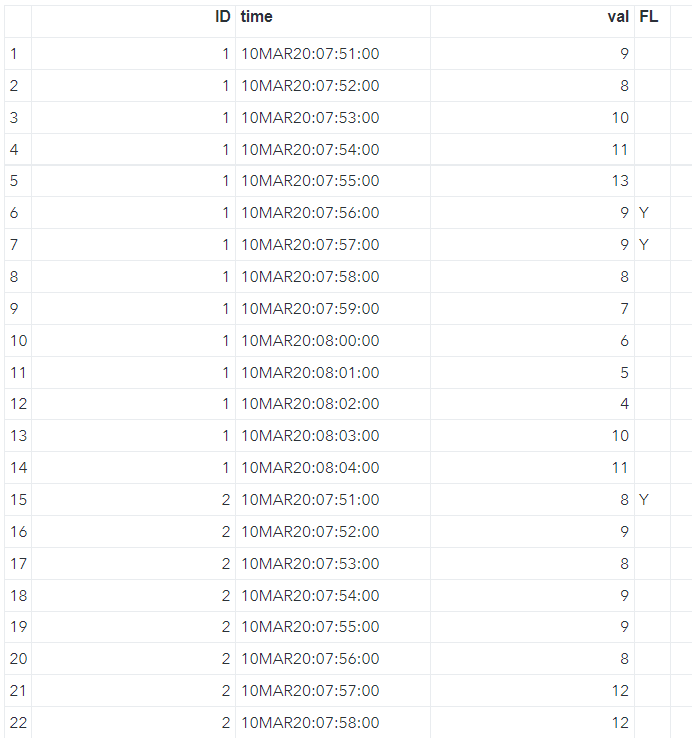
こんな感じに,1分刻みに値が記録されたデータがあったとします
で例えば値が10未満のものにフラグをたてるとかなら

if val < 10 then FL="Y";

でOKです

ところが難しいのが,
10未満の値が観測されてから後5分以内に10以上の値が観測されなかった場合のみ,その時点にYをたてて.といわれたらどうしましょう?

簡単なのはデータのソート順をひっくり返して後ろからみるとかなのですが
今回,仮の前提としてデータが巨大で,安易にひっくり返しソートがうてないという状況としてみましょう

そうなるとSASの1obsよんで1obs出力する方法だと先読みしにくいのですね
完全に1分刻みが確定してるなら前回の方法で5obs先までみればいいのですが
色々な要因で測定メッシュが確定しない場合もあるかもしれません(というかよくあります…)

そうなるとちゃんと時間と条件を加味して先読みしたいと.
そういう時にハッシュオブジェクトが活きてくるんですね

必要最低限な変数に絞って自己参照していけばいいので

data wk1;
set temp;
if _N_=1 then do;
call missing(of _time _val);
    declare hash h1(dataset:"temp(rename=(time=_time val=_val))",multidata:"yes",hashexp:16);
        h1.definekey("ID");
        h1.definedata("_time","_val");
        h1.definedone();
    end;
if val < 10 then FL="Y";
 do while ( h1.do_over()=0 );
      if 0<_time-time<=300 then do;
            if _val>=10 then call missing(FL);
      end;
 end;
drop _val _time;
run;

じゃっかん無駄のある処理(自分より前のデータからもいちいちスタートしてる)ですが
とりあえず単純化した例を示したかったのです


multidataでIDでkey重複した状態でハッシュオブジェクトを定義しておいて
do_overメソッドで同IDのデータを総なめして,5分以内にアンチ条件に合致するレコードがあればフラグをおると.
そうすると結果的に5分間条件持続の確認されたものにフラグがたつと(正確にはレコード終わりの終了5分前のところからは5分間確認できてなくてもフラグがたつ)

なんか臨床の分野でもePROやデバイスが増えたり,time to eventのパラメータ条件も昔よりちょっと複雑になった気がしてて,最近この手の処理を書く機会が増えたなーって印象です

①SASでデータサイエンス100本ノック(構造化データ加工編)

データサイエンティスト協会から2020年6月15日からGitHubで公開してるデータサイエンス100本ノック(構造化データ加工編)ですが

その100本をSASで書いたので,私のブログでレビューしてくださいという,非常に面白い連絡を某Mさんからいただきました

なので,気の向くままに適当にとりあげれればと

005:

【行に対する操作 / 複数条件 / 複数条件に合致する行を抽出する】

レシート明細のテーブル(df_receipt)から売上日(sales_ymd)、顧客ID(customer_id)、商品コード(product_cd)、売上金額(amount)の順に列を指定し、以下の条件を満たすデータを抽出せよ。

顧客ID(customer_id)が"CS018205000001"

売上金額(amount)が1,000以上

/*Mさま*/

data s005; format sales_ymd customer_id product_cd amount ; keep sales_ymd customer_id product_cd amount ; set df_receipt; where customer_id = 'CS018205000001' & 1000 <= amount; run; proc print data = s005; run;

好みの問題で
私は割と
&(and)でwhere抽出条件をつなぐのが好きではなく

where customer_id = 'CS018205000001'; where same 1000 <= amount; としかかかないかなぁ.コメントアウトして条件絞りを変えやすいし

007問題の

  • 顧客ID(customer_id)が"CS018205000001"
  • 売上金額(amount)が1,000以上2,000以下
where customer_id = 'CS018205000001' & amount between 1000 and 2000;

整数値が前提なら amout in (1000:2000);の方が書きがちですが正しいのはbetweenの気がします

013問題の
顧客テーブル(df_customer)から、ステータスコード(status_cd)の先頭がアルファベットのA~Fで始まるデータを全項目抽出し、10件だけ表示せよ。
where substr(status_cd , 1 , 1) between 'A' and 'F';

↓
where first(status_cd , 1) between 'A' and 'F';

first関数とchark関数が好きで,substrの第三引数が1になるようなケースで私はsubstr使わないかなぁ

末尾ならreverseしてからfirstするかcharで第二引数にlengthいれるかなぁ

とりあえず,ここまで

Nオブザベーション先の値を取得する話①

Nオブザベーション前の値を保持して取得する場合,retain使ったり,lag関数使えばよいのですが(lag関数の注意点参照 https://sas-boubi.blogspot.com/2021/05/lag.html)
data A;
set sashelp.class;
pre1_age=lag(age);
pre2_age=lag2(age);
keep name age pre:;
run;


これを逆にしようと思うと,1obs読んで1obs出力するSASの仕組み的にはつらいものがあります.
もう一回sort順逆にして前のobsをとれば一応は先をとったのと同じことにはなりますが
データが巨大だったりすると,みだりにソートやステップを重ねることが難しかったりします

data B ;
set sashelp.class(drop=height weight);
_DSID = open("sashelp.class(keep=age rename=(age=_age))") ;
call missing(_age);
call set(_DSID) ;
rc = fetchobs(_DSID, _N_+1) ;
if rc ne 0 then call missing(_age);
run;

open関数でsetと同じデータセットを指定して,IDづけして
setしてる親元の_N_に+1した数で,任意のobsをブッコ抜くfetchobsでもってくる.
欲しい変数のみ残していて,リネームしているので結果的にリネーム結合と同義になる
ハッシュオブジェクトと同じくPDV外からきた変数は,PDVでの値のクリーンアップがかからないので,retainされてしまう.そこでリターンコードrcを処理にからめる
rcはfetchobsが成功,つまり1obs先がある場合のみ0なので,0以外の場合は初期化
SCL関数をデータステップ内で使った場合,終了時に自動でcloseがかかるのでclose関数は省略

これをマクロで汎用化するなら
%macro next_look(master=,var=,postn= );
if 0 then set &master(keep=&var rename=(&var=next&postn._&var));
length &master.&var.&postn. 8.;
retain &master.&var.&postn.;
if missing(&master.&var.&postn.) then do;
&master.&var.&postn. = open("&master(keep=&var rename=(&var=next&postn._&var))") ; 
call set(&master.&var.&postn.) ;
end;
rc = fetchobs(&master.&var.&postn., _N_+&postn) ;
if rc ne 0 then call missing(next&postn._&var);
drop &master.&var.&postn. rc ;
%mend;

こんなの
data C ;
set sashelp.class;
%next_look(master=sashelp.class,var=name,postn=1);
%next_look(master=sashelp.class,var=age,postn= 1);
%next_look(master=sashelp.class,var=age,postn= 2);
keep name age next:;
run;


でも,優秀な後輩からの指摘で,それなら単純にpoint setの方が速度でるんじゃねえっすか?
ってことで

data z;
set sashelp.class;
__n = _n_ + 1;
if 1 <= __n <= nof then set sashelp.class(keep = age rename = (age = next_age)) point = __n nobs = nof;
else call missing(next_age);
keep name age next_age;
run;


確かにねー.

で,巨大なデータにしてみたり,色んなシチュエーションで実験してみたけど
fetchobsもパフォーマンス悪くはないけど,常にpoint setの方がややいい感じ.

簡素性や,SCL関数とか下手に使ってない観点からしてもset pointの方がいいですね

いやー,できる後輩がいると辛いですね(笑)

次回は,いつになるかわからないですが,条件付きで先を見る話です
(○○時間経過以内の特定の値をとるとか,そのobsの先に特定条件を満たすものがあった場合のみ取得する みたいなものには単純な割り当て法だとつらい)